Больше трёх лет назад я писал про резервное копирование баз данных в Кибер Бэкап. Та статья была написана по 15-й версии, и главный вывод в ней был грустный: бекап есть, а вот восстановление местами выглядит так, будто его забыли доделать. Про PostgreSQL я потом дописывал отдельно, в статье про 16-ю версию, но с тех пор воды утекло тоже много, 22 октября состоится релиз 19 версии и пора всю информацию по БД актуализировать.
Я решил собрать всё, что изменилось с момента моей последней статьи для MSSQL, MySQL/MariaDB и PostgreSQL.
MSSQL
Принцип работы остался прежним: агент для SQL на машине с сервером, копирование через VSS и SQL Writer, в копию попадают файлы баз (mdf, ndf, ldf). Безагентский режим так и не появился. Но накопилось несколько изменений и уточнений.
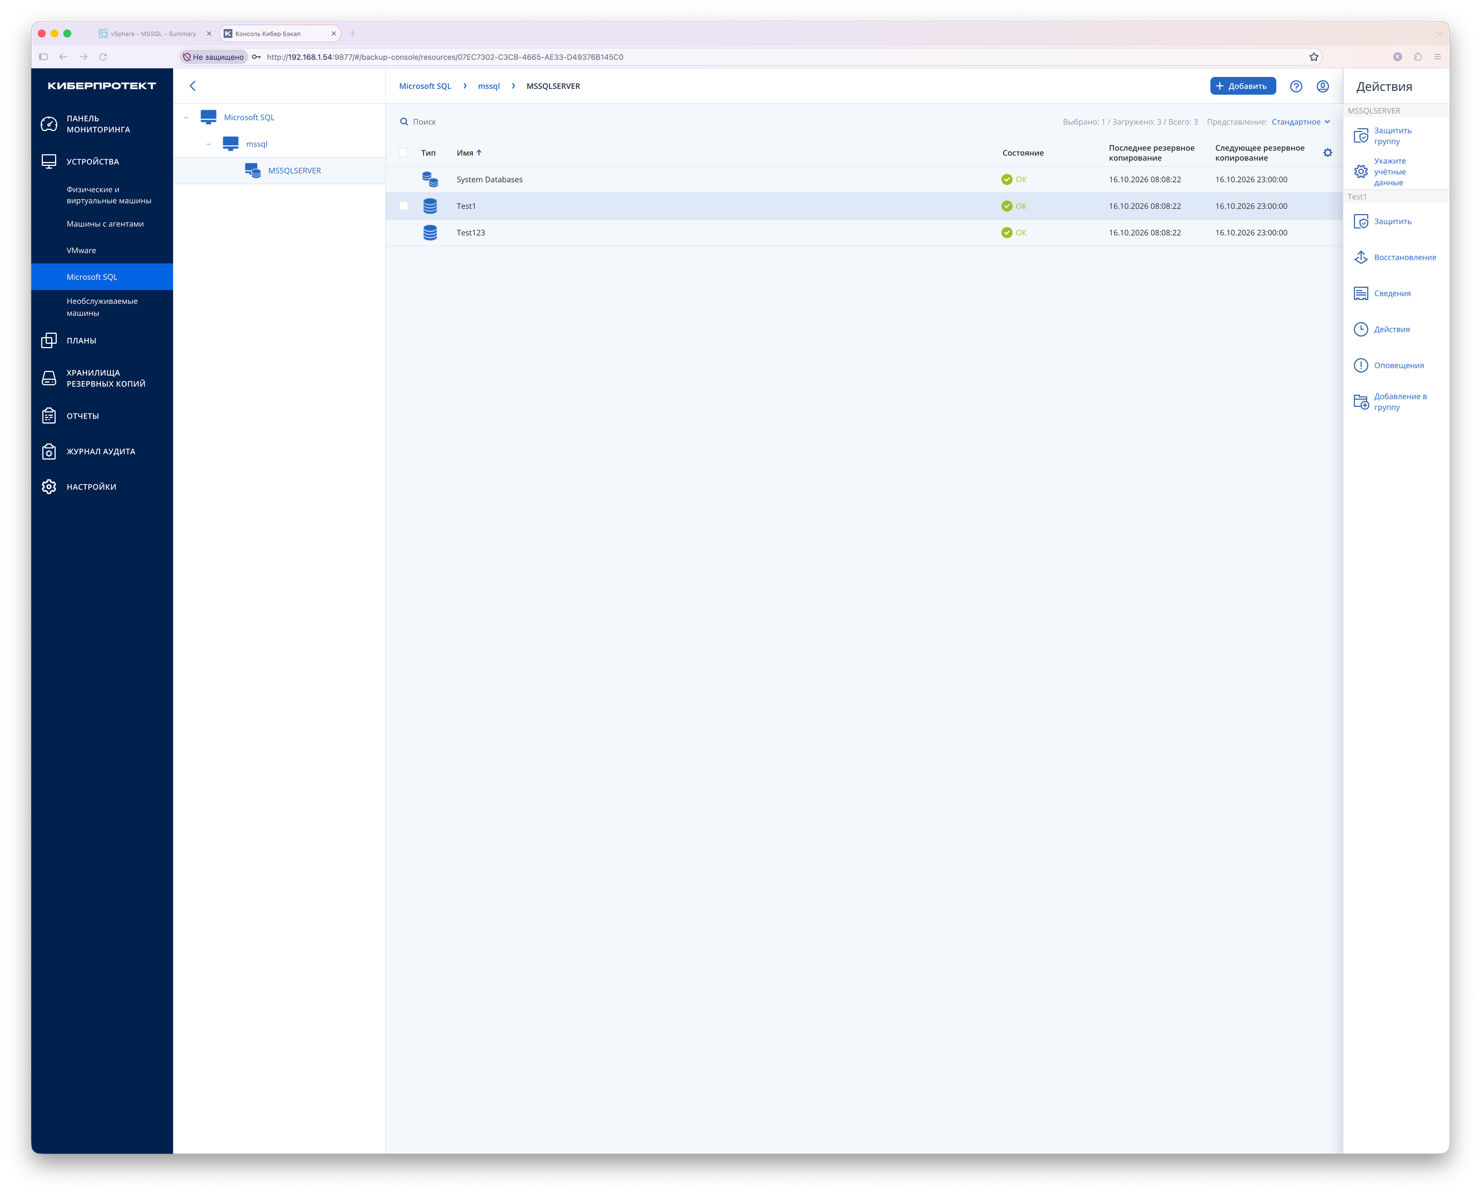
Восстановление
Вариантов восстановления сейчас три:
- в запущенный экземпляр SQL Server
- в виде файлов в локальную или сетевую папку, чтобы потом подключить их к экземпляру руками или отдать на анализ
- подключение баз к экземпляру
Системные базы восстанавливаются тоже. При восстановлении master экземпляр автоматически перезапускается в однопользовательском режиме, после чего восстанавливаются остальные базы.
Point-in-time
В 2022 году я писал, что журналы транзакций Кибер Бэкап не бекапит и ни о каком Point-In-Time речи нет. Что изменилось? Формально PITR для MSSQL в документации появился, но давайте посмотрим, как он устроен. Порядок такой:
- восстанавливаем базу из резервной копии Кибер Бэкап с состоянием NORECOVERY
- накатываем журналы транзакций из резервных копий средствами самого Microsoft SQL (задание на BACKUP LOG)
То есть журналы транзакций Кибер Бэкап по-прежнему не копирует. Их нужно делать штатными средствами SQL Server и хранить где-то рядом. Кибер Бэкап в этой схеме отвечает только за «базовую» копию, на которую вы потом накатываете логи. Помимо этого, если делаете BACKUP LOG штатно, опцию „Сокращение журнала“ в плане нужно отключить, иначе PITR не получится. Если логи не бекапите, опция удерживает их размер под контролем.
Always On (AAG)
Поддержка AAG была и в 2022 году, но теперь у неё есть нормальное описание, поэтому коротко зафиксирую условия:
- SQL Server 2012 и новее, группа доступности в отказоустойчивом кластере Windows Server (WSFC)
- агент для SQL нужен на каждом узле кластера, причём набор выбранных баз должен совпадать на всех узлах
- не поддерживаются экземпляры отказоустойчивого кластера (FCI), зеркалирование и доставка журналов
Отдельно отмечу ограничение, которое вытекает не из Кибер Бэкап, а из самого SQL Server: базу, входящую в AAG, перезаписать при восстановлении нельзя. Рекомендованная последовательность такая: восстанавливаем как новую базу (другое имя, пустая папка), проверяем в SSMS, удаляем старую, переименовываем восстановленную и возвращаем в AAG.
Что я бы ожидал увидеть в следующих версиях? Естественно, полноценный PITR и безагентское РК, как это есть у большинства конкурирующих продуктов. Конечно же нужен Instant recovery / публикация баз, довольно часто слышу этот запрос. Восстановление отдельных объектов тоже было бы крайне полезным. Но на самом деле, учитывая, что курс сегодня у большинства компаний на импортозамещение, и многие отказываются от использования MSSQL, я не сильно надеюсь на то, что что-то из этого появится в будущих релизах.
MySQL / MariaDB
Здесь изменений нет вообще.
PostgreSQL
Поддержка PostgreSQL развивается в Кибер Бекап активнее всего. Если в 2022 году она только зарождалась и была очень сомнительной, то сейчас это уже полноценная система, хоть и с нюансами. Историю по версиям, можно сложить так:
15.0 – поддержка резервного копирования PG. Только полные резервные копии с использованием только локальных хранилищ.
16.0 – инкрементное резервное копирование. Поддержка схем резервного копирования: всегда полная; еженедельно полная, ежедневно инкрементальная; пользовательская. Поддержка сетевых хранилищ, хранилищ узлов хранения и лент.
16.5 – Гранулярное восстановление: из резервной копии можно восстановить только необходимые данные. Поддержка восстановления БД на заданный момент времени (Point in Time Recovery). Монтирование и просмотр содержимого экземпляра PostgreSQL для восстановления отдельных таблиц без необходимости восстановления всего экземпляра целиком. Восстановление в dump-файл. Добавлена поддержка высокодоступных кластеров PostgreSQL Patroni.
17.0 — поддержка Кибер Ифраструктуры как хранилища, внешних S3 хранилищ.
17.1 — Pre- и post-команды для операций резервного копирования и восстановления.
17.3 — Восстановление баз данных PostgreSQL: снято ограничение системной утилиты PostgreSQL на восстановление баз с большими объектами.
18.0 — Многопоточность полного файлового резервного копирования и восстановления экземпляров PostgreSQL.
18.5/18.6 — Многопоточное резервное копирование PostgreSQL и СУБД на её основе в новых схемах инкрементного резервного копирования для экземпляров СУБД: файловый инкремент, файловый инкремент + журнал транзакций.
19.0 — многопоточное полное копирование в кластерах Patroni и Jatoba с настройкой в интерфейсе, поддержка walsummary (PostgreSQL 17+) и выбор механизма копирования в плане защиты: собственный многопоточный или libpgprobackup от Postgres Professional.
Как настраивается
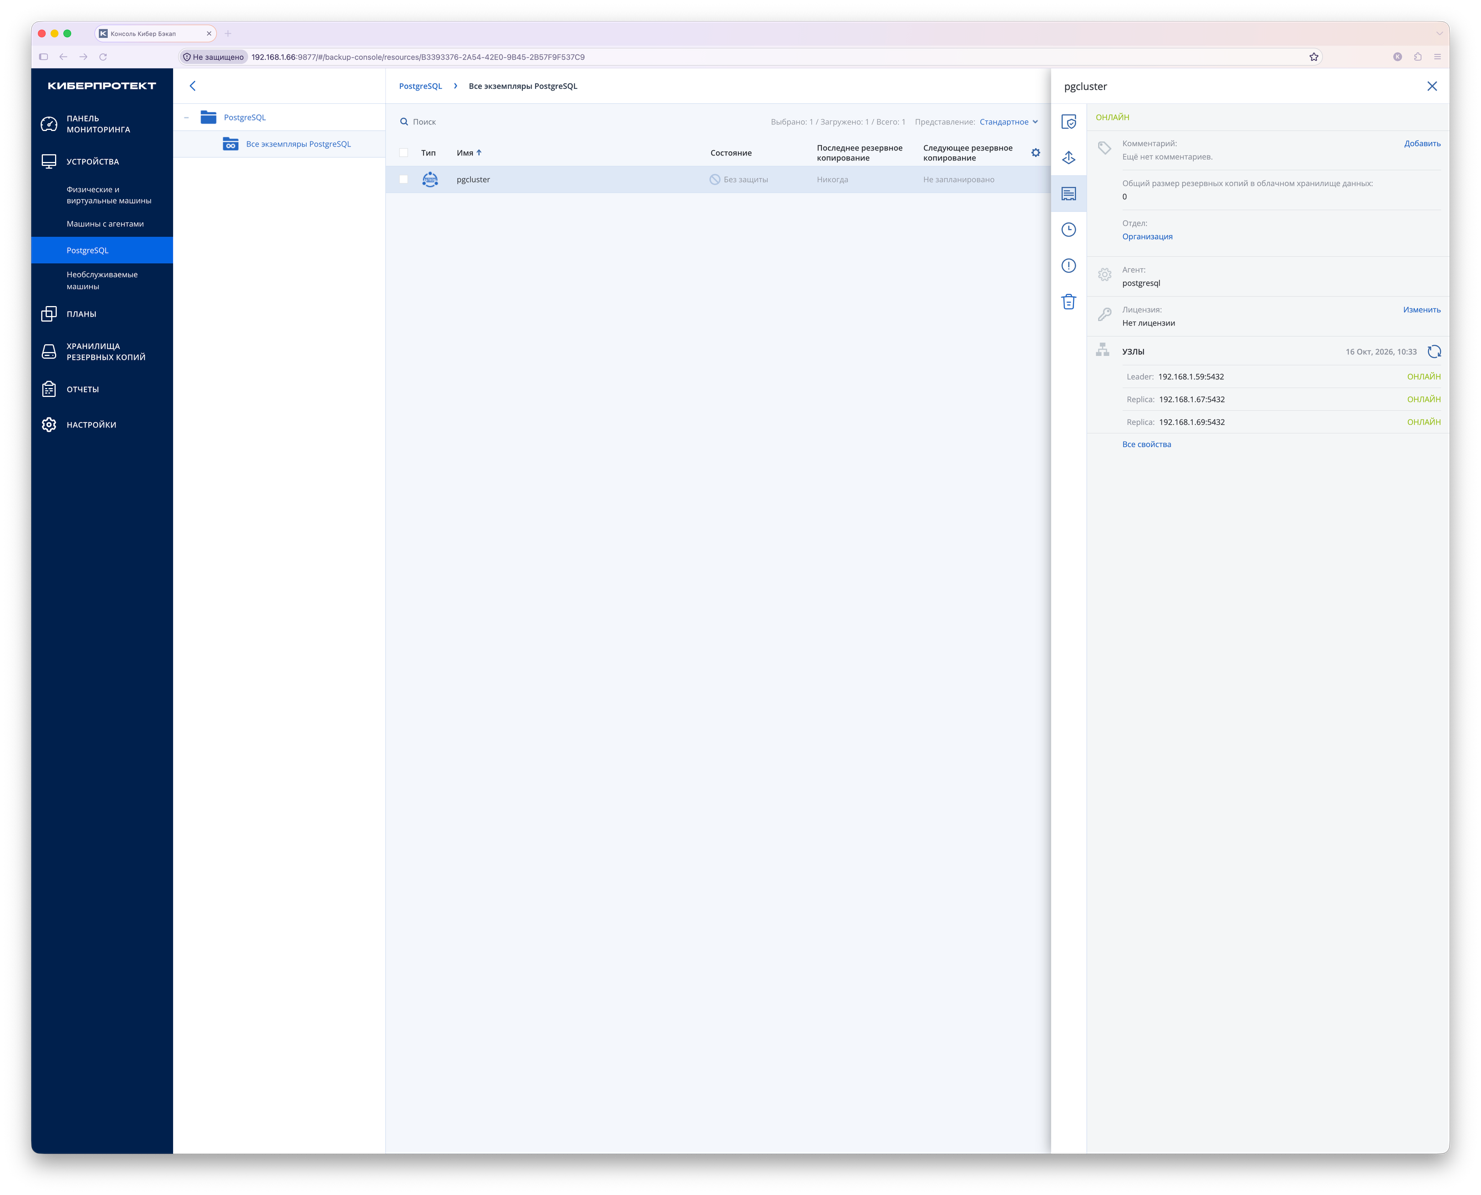
Процесс остался прежним: на сервере с PostgreSQL ставится агент для Linux и агент для PostgreSQL, экземпляр добавляется в раздел «Устройства → PostgreSQL». Для подключения нужна учётная запись с правами SUPERUSER, в pg_hba.conf должны быть записи для подключения агента (в том числе для базы replication), а в postgresql.conf задаётся listen_addresses.
Куда можно сохранять
Главная претензия 2022 года была в том, что копии можно было класть только на тот же сервер. Теперь доступны локальная папка, сетевая папка, узел хранения, Кибер Инфраструктура / Кибер Хранилище, NFS и SFTP. Ограничения у узла хранения есть: полное копирование в хранилище с включённой дедупликацией не поддерживается, а защищённое паролем хранилище узла хранения тоже не подходит.
Схемы резервного копирования
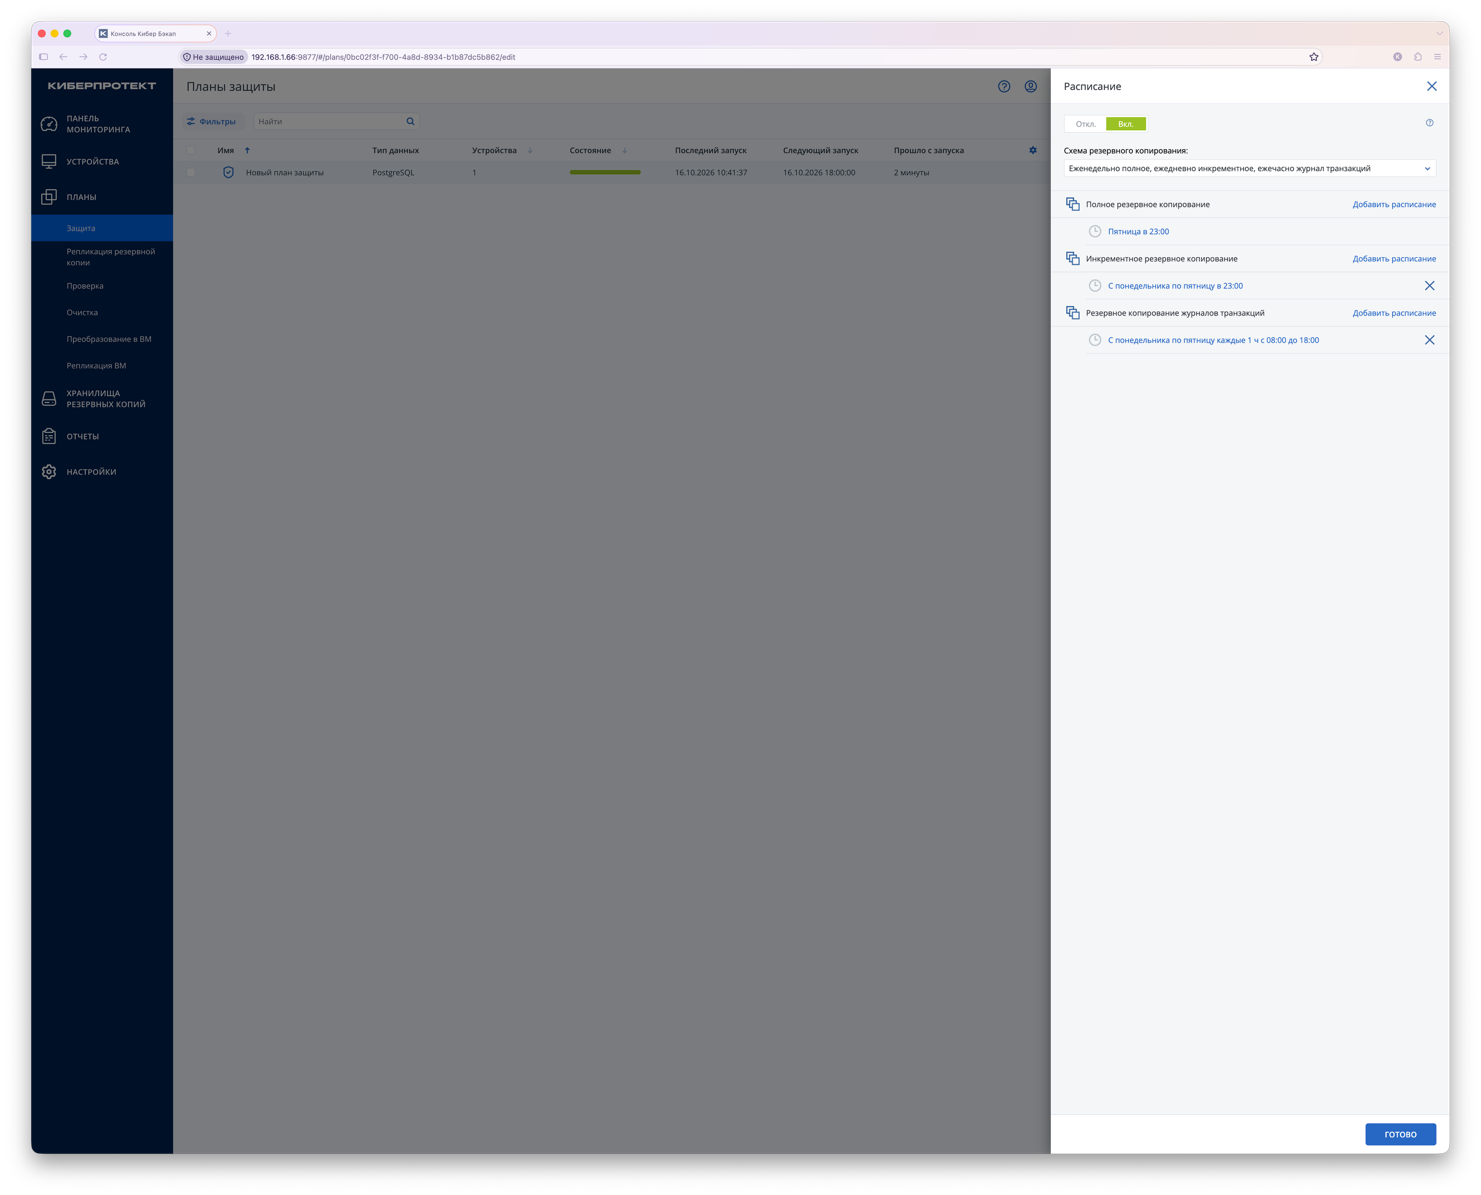
Сейчас в плане защиты можно выбрать:
- «Всегда полное»
- «Еженедельно полное, ежедневно журнал транзакций»
- «Еженедельно полное, ежедневно инкрементное, ежечасно журнал транзакций»
- «Другое»
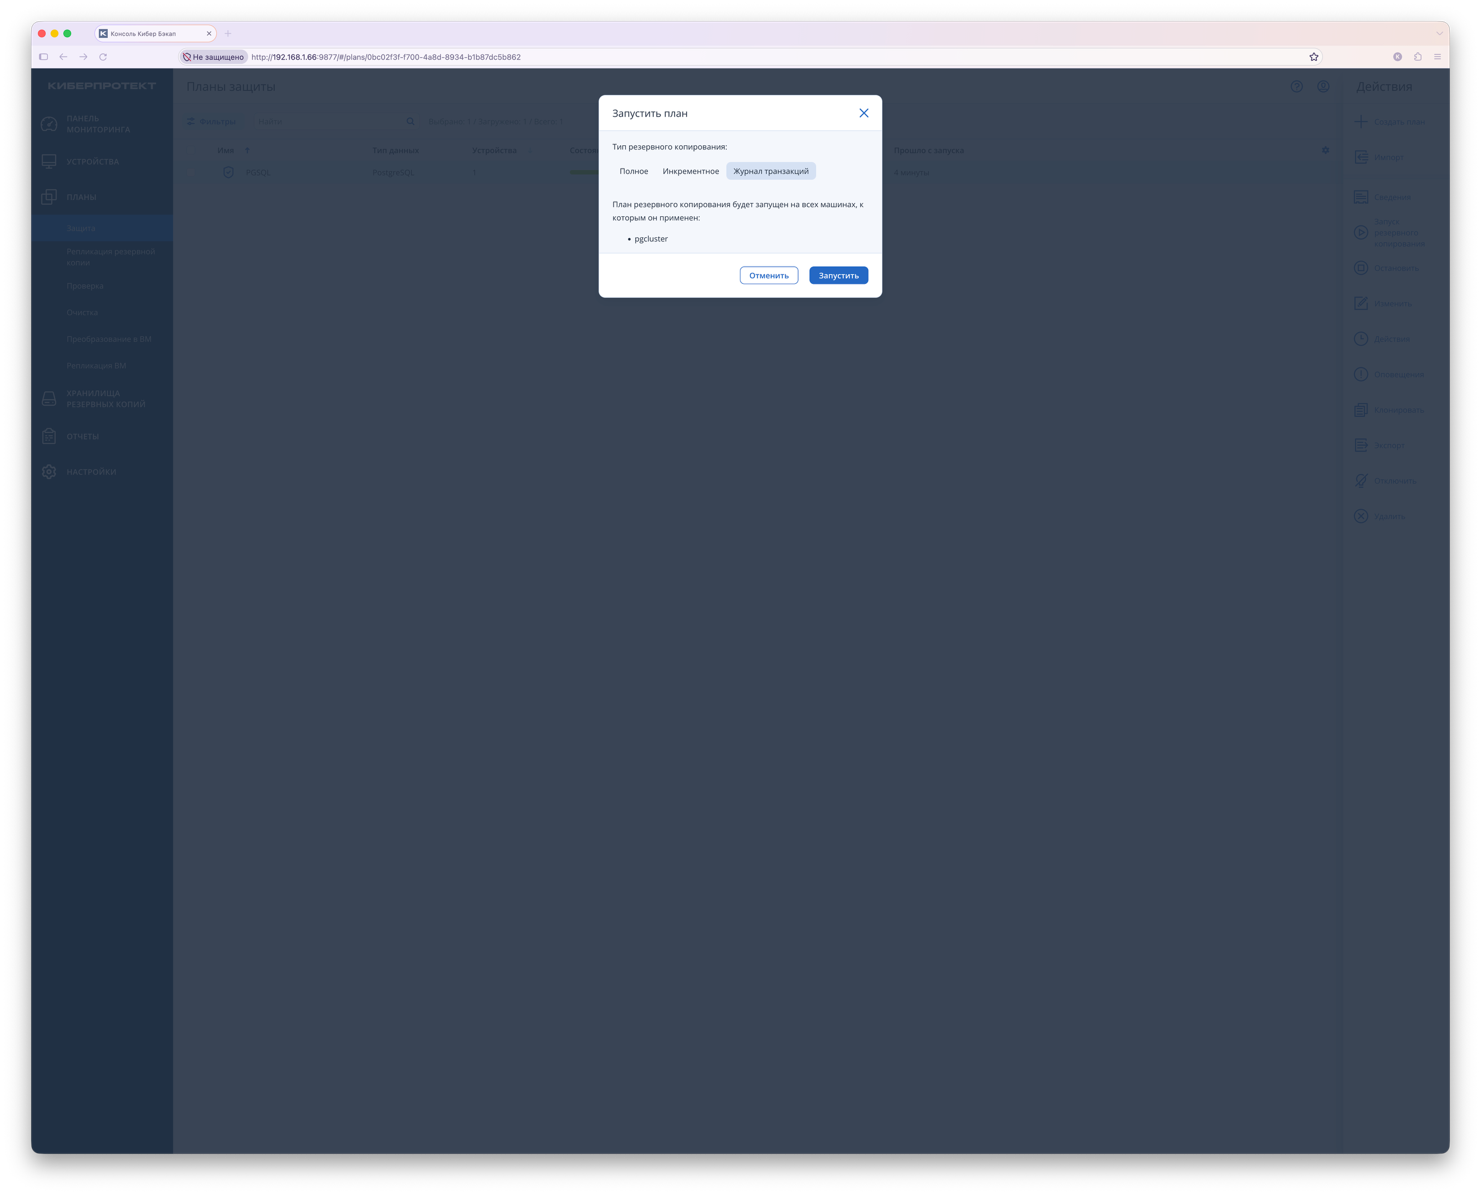
Тут стоит быть внимательным, потому что понятия «инкрементная копия» и «копия журнала транзакций» для PostgreSQL теперь разные вещи.
Восстановление
Вот где произошла настоящая революция. Раньше восстановление выглядело так: копия клалась в каталог на сервере, а потом вручную создавался recovery.signal и дописывался restore_command. Теперь вариантов три:
- Восстановление экземпляра в виде файлов. Тот самый старый сценарий в улучшенном виде: файлы кладутся в локальную или сетевую папку машины с агентом, можно задать команды до и после.
- Подключение экземпляра из архива. Да, для PostgreSQL реализован свой аналог Instant recovery — резервная копия монтируется как работающий экземпляр, с которым можно работать штатными средствами PostgreSQL: посмотреть данные, выполнить запросы, ничего не восстанавливая в продуктив. Для этого на машине с агентом должна совпадать ОС, версия и редакция PostgreSQL, а в файле postgresql-agent.json нужно прописать путь к бинарным файлам (секция recovery_instance).
- Гранулярное восстановление баз. Можно выбрать конкретные базы и восстановить их в исходные или новые базы, либо выгрузить в dump-файлы. Целевой экземпляр должен быть не ниже по версии, редакция совпадать; кластерный можно восстанавливать на некластерный и наоборот. Работает только на Linux.
PITR
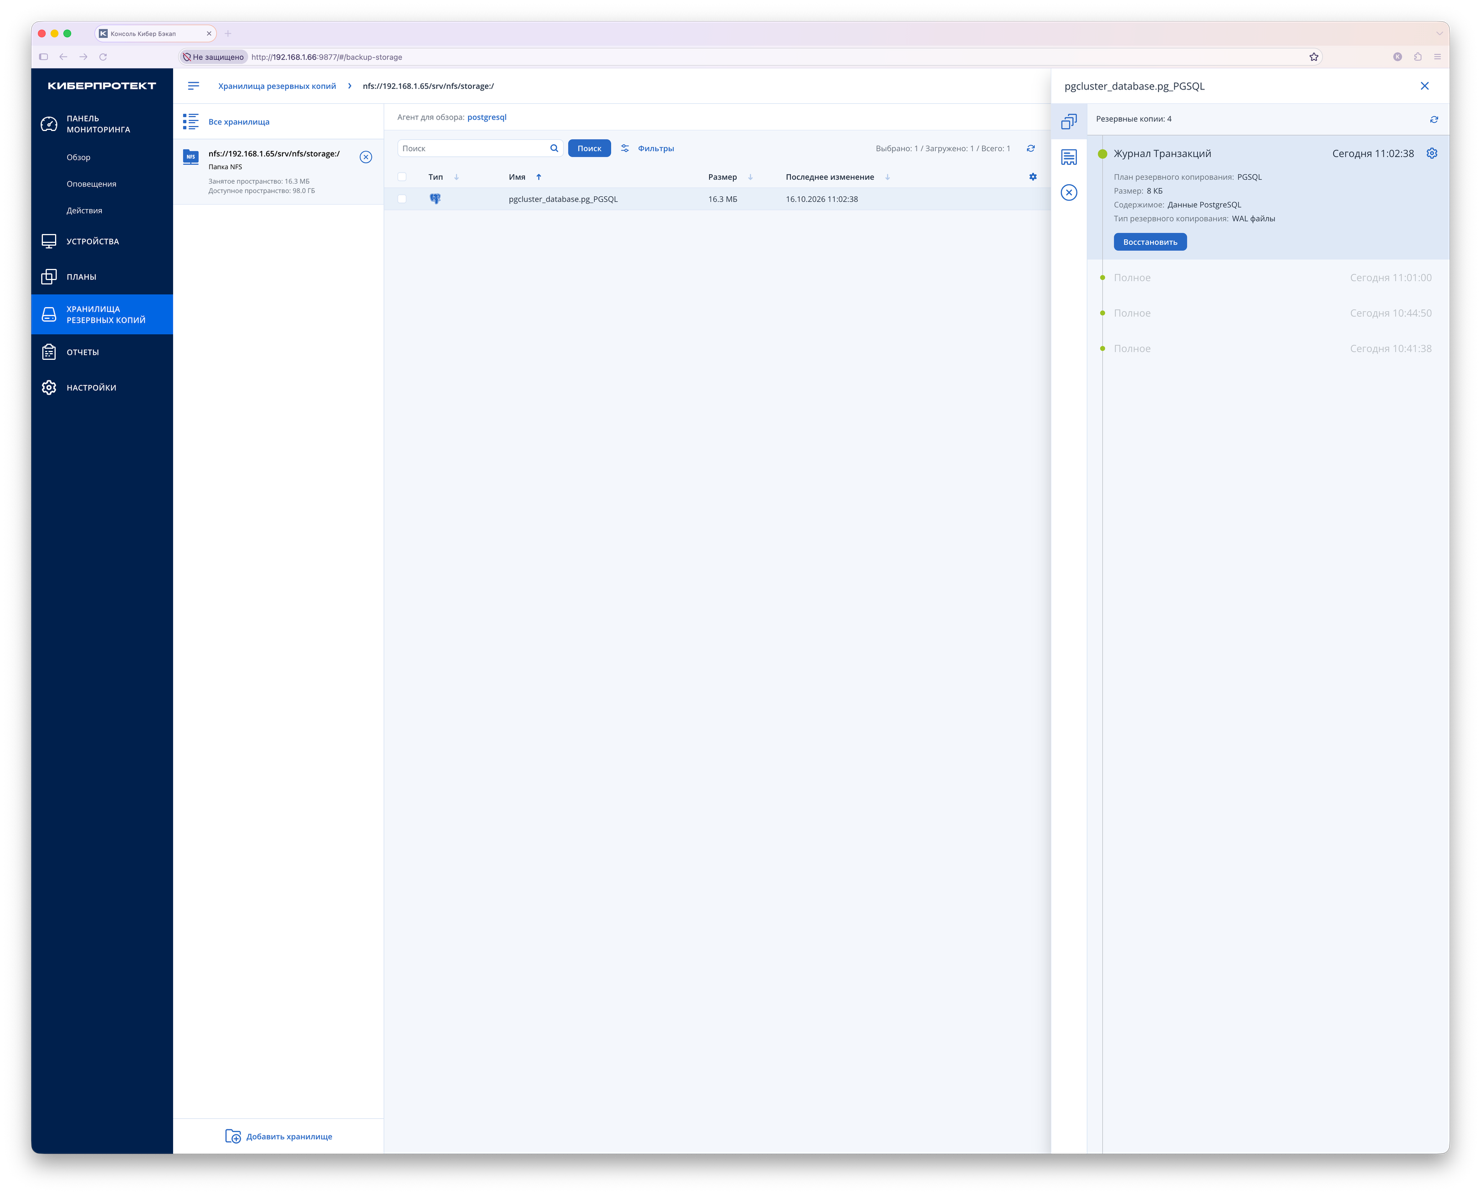
Восстановление на момент времени доступно, но только для резервных копий журналов транзакций. Момент можно выбрать между двумя соседними копиями. У PITR есть два ограничения:
- диапазон PITR доступен только в исходном архиве; при репликации архива он остаётся только на источнике
- при копировании архива в другую папку диапазон PITR в новом месте пропадает
Если вы планируете держать копии в двух местах (а любой здравомыслящий администратор так и делает), то помните: «точное» восстановление будет работать только с первичным архивом.
Прочие ограничения
- гранулярное восстановление не поддерживается на Windows;
- гранулярное восстановление из копий на ленте не поддерживается
- полное копирование в хранилище узла хранения с дедупликацией и с защитой паролем не поддерживается
Что добавят в КБ 19
Для PostgreSQL в 19-й версии анонсированы три крупных изменения. Документация к 19-й пока не опубликована, поэтому детали могут отличаться.
1. Многопоточное полное копирование в кластерах Patroni и Jatoba. Многопоточность появилась ещё в 18.5 для новых схем инкрементного копирования, а теперь её распространяют на полное копирование в кластерных конфигурациях. Количество потоков можно будет настраивать в графическом интерфейсе. На больших базах именно полная копия обычно определяет окно бекапа, так что это изменение выглядит самым практичным.
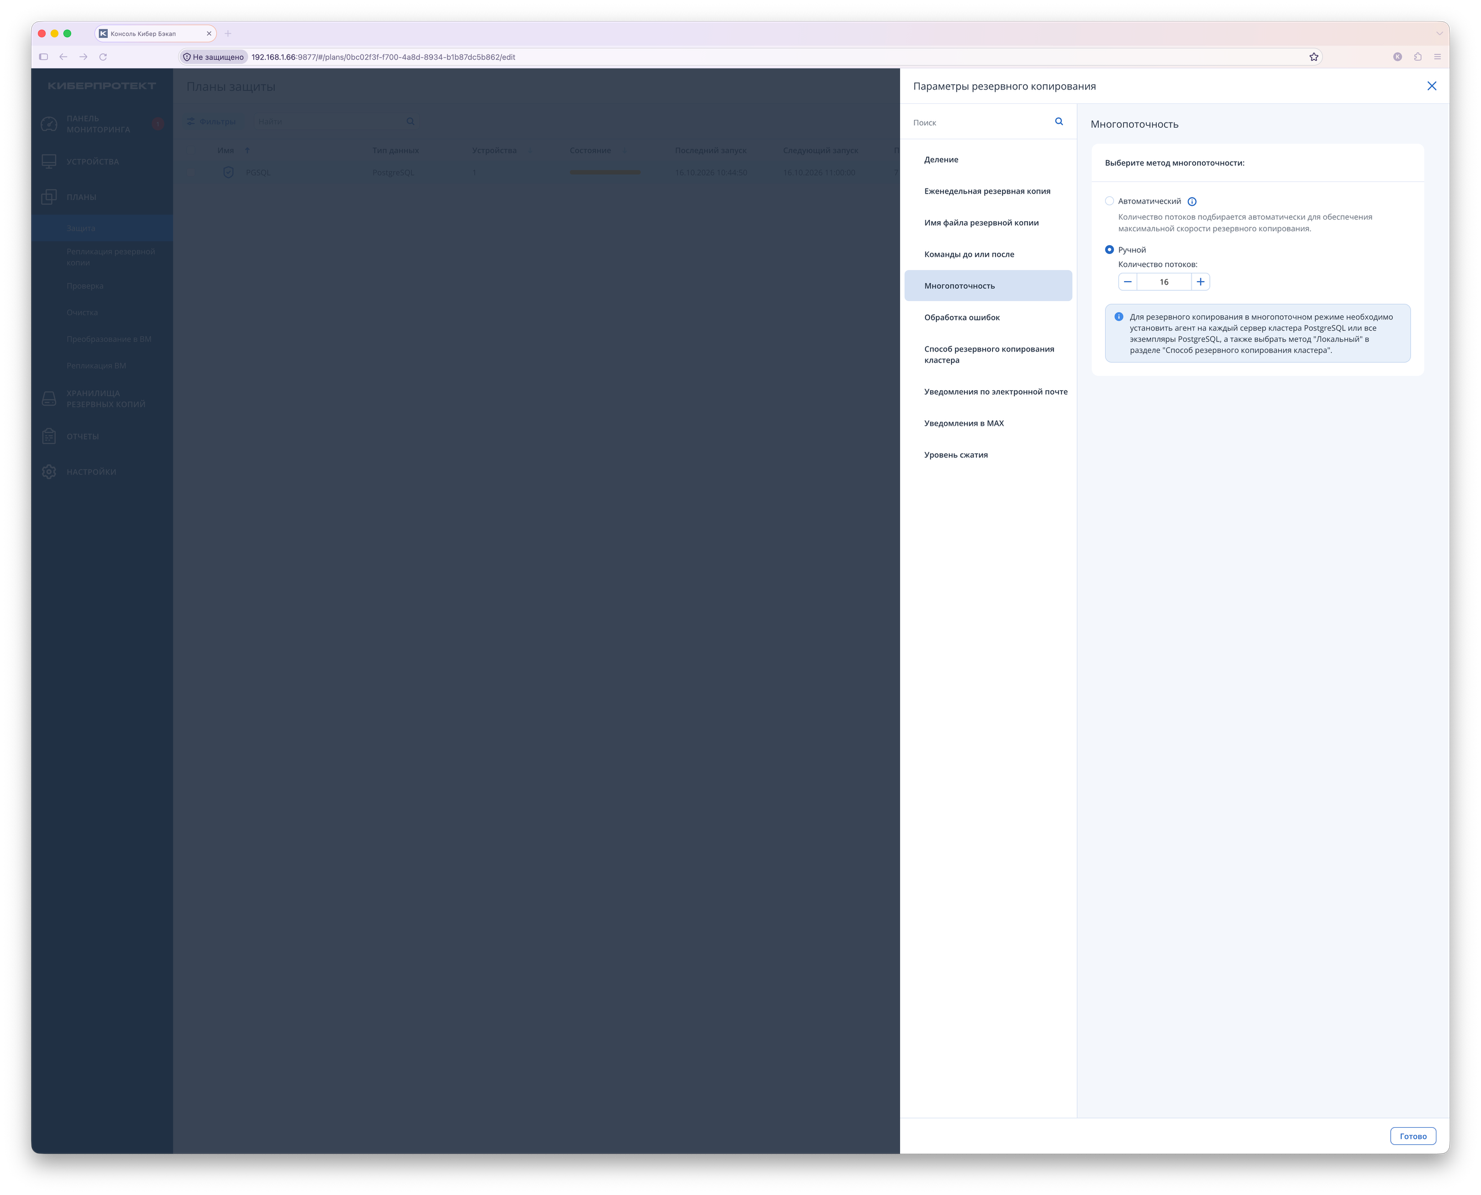
2. Поддержка walsummary. Это механизм самого PostgreSQL, начиная с 17-й версии: при включённом параметре summarize_wal фоновый процесс walsummarizer ведёт сводки о том, какие блоки менялись в WAL. Благодаря этому инкрементная копия может не сканировать все файлы данных в поисках изменений, а сразу знать, что копировать.
3. Поддержка libpgprobackup. Это проприетарная библиотека Postgres Professional, которая заменяет внешнюю утилиту pg_probackup и подключается напрямую. В плане защиты можно будет выбрать механизм копирования:
- собственный многопоточный файловый механизм Кибер Бэкап (в варианте с параллельным копированием WAL и без него)
- libpgprobackup
Анонс не уточняет, какие именно СУБД поддерживают libpgprobackup: сказано только «для поддерживающих её СУБД». Логично предположить, что это Postgres Pro, а вот будет ли это работать на «обычном» PostgreSQL, неизвестно.
Из всего написанного можно сделать вывод, что развитие поддержки PostgreSQL уделяется огромное внимание, есть чёткий вектор и функционал в новых версиях добавляется очень активно, что не может не радовать.
Oracle
В первой статье я Oracle не касался вообще, так что тут не «изменения», а скорее знакомство. Документация по Oracle сейчас устроена в два слоя: отдельный раздел для 11g/12c и более новый раздел для остальных версий. По таблице совместимости поддерживаются Oracle Database 11–19, все выпуски.
Два способа бекапа
Для 11g/12c документация описывает два метода:
- Резервное копирование сервера — копия машины целиком с согласованным состоянием Oracle (с поддержкой приложений). Плюсы: можно очень быстро восстановить весь сервер и всё настраивается в интерфейсе без знания RMAN. Минусы: база должна лежать на обычной файловой системе; raw разделы и ASM не поддерживаются.
- Резервное копирование базы данных — через Oracle RMAN. Сначала копии создаются в локальной папке, затем уже эта папка копируется в хранилище; локально остаются только последние копии. Поддерживаются raw разделы и ASM, но восстановление всего сервера дольше.
Практически это реализовано в виде двух планов защиты на папку с RMAN-копиями: один для полных копий, другой для архивных журналов. В каждом включается команда «до копирования», которая запускает скрипты из комплекта агента (backup_full_pre и backup_incr_pre).
Новые версии
Для более новых версий Oracle (в документации сказано про версии старше 12) отдельный агент для Oracle не нужен, достаточно агента для Linux. Резервное копирование строится на связке команд до и после бекапа с RMAN. Поддерживаются полные, инкрементальные копии и копии архивных журналов, при этом сохраняются обычные возможности плана: расписание, хранилища, правила хранения, сжатие и защита паролем. Конфигурация RAC поддерживается, а про Data Guard прямо ничего не сказано, кроме упоминания копирования standby-баз.
Восстановление
Здесь тоже варианты:
- восстановление сервера целиком, в том числе на «голое железо»
- восстановление через Oracle Explorer — отдельный графический инструмент, запускаемый на сервере с агентом для Oracle. Он в два шага: сначала достаёт нужные файлы (табличные пространства, архивные журналы, при необходимости контрольный файл и SPFILE), потом запускает команду восстановления RMAN. Умеет полное восстановление до последнего состояния и неполное на момент времени или номер SCN.
- восстановление скриптами — из последней локальной копии RMAN или из более ранней
Для новых версий PITR описан как цепочка действий: восстановить копию из хранилища, распаковать, применить команды средствами СУБД. Время можно указать в разных форматах или задать SCN.
Итого
Если сравнивать с 2022 годом, то лидер по развитию — PostgreSQL. Именно там вендор сделал то, чего не хватало: инкременты, места хранения, мгновенное и гранулярное восстановление, PITR. MSSQL развивается спокойнее, но скорее всего в скором времени его постигнет участь MySQL, на который внимания почти не обращают. Oracle в целом держится на скриптах RMAN и собственном графическом инструменте для 11g/12c.
Теперь о том, что мне по-прежнему не нравится:
- у разных баз по-прежнему разный подход к настройке защиты и восстановлению: MSSQL из раздела «Microsoft SQL», PostgreSQL из «PostgreSQL», MySQL с агентом для Linux, Oracle через скрипты и pre/post-команды. Общей логики нет
- безагентского восстановления баз так и не появилось. Для просмотра копии и запуска восстановления почти всегда нужна машина с агентом
- PITR есть не везде и устроен по-разному: у PostgreSQL он нативный, у MSSQL требует отдельных бекапов журналов штатными средствами, у Oracle строится на RMAN
- у PostgreSQL PITR теряется при копировании или репликации архива, а это ровно тот сценарий, о котором все говорят в разговорах про правило 3-2-1
Хорошая новость в том, что динамика есть. Да, она не для всех БД равномерна, есть явный перекос фокуса, но и многие на российском рынке отказываются от Microsoft SQL и Oracle.